이터레이터 패턴, 순회 로직을 자료구조에서 분리하기
이터레이터 패턴은 컬렉션의 내부 구조를 감추고 요소를 하나씩 순회하게 하는 GoF 행위 패턴이다. 자바·파이썬·자바스크립트·스위프트의 구현 차이와 외부·내부 이터레이터, fail-fast 함정을 예제로 정리했다.
목차
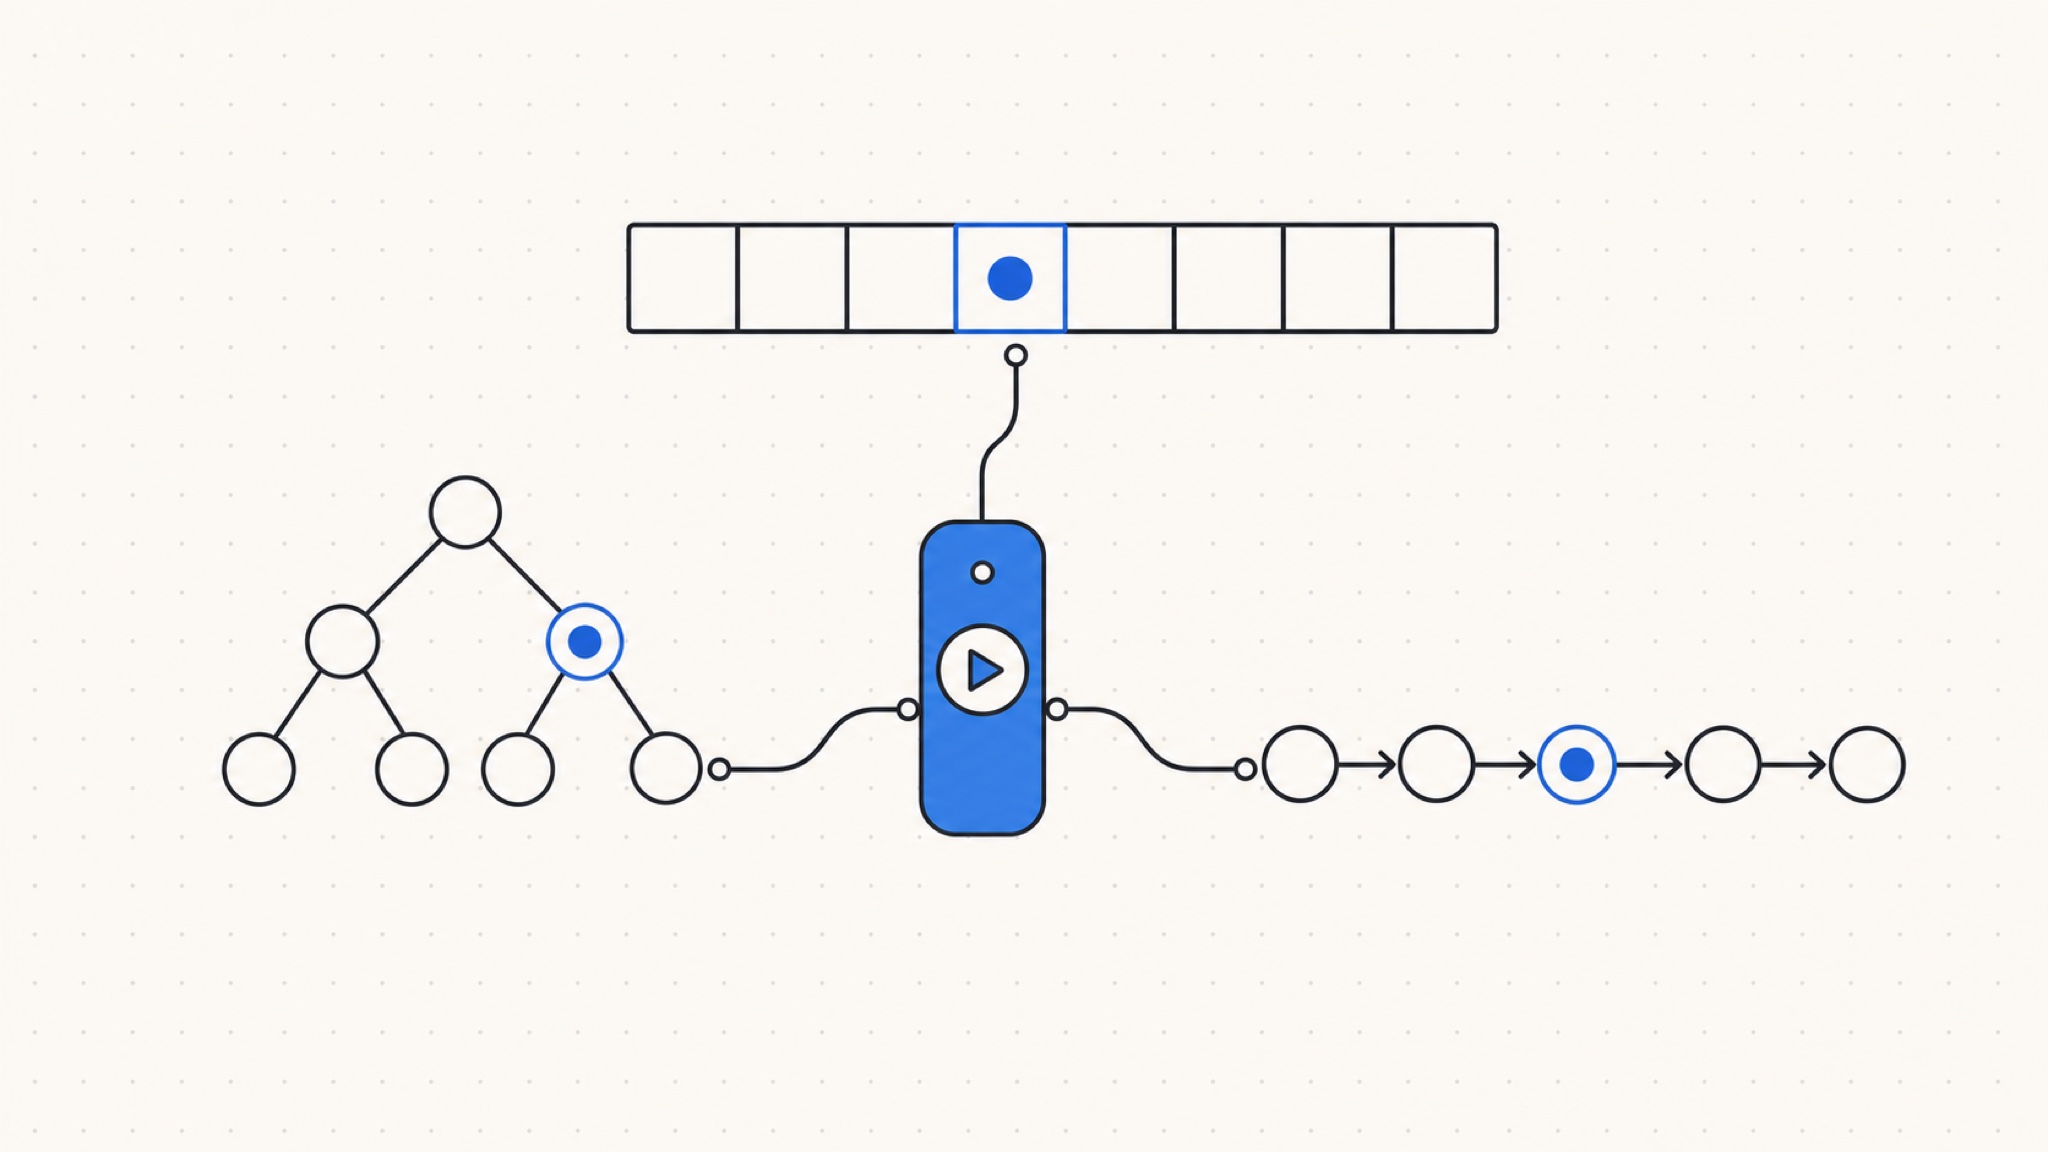
이터레이터 패턴은 컬렉션의 내부 구조를 드러내지 않고 요소를 하나씩 순서대로 꺼내는 방법을 제공하는 설계 패턴이다. 배열이든 연결 리스트든 트리든, 순회하는 쪽은 '다음 요소를 달라'는 약속 하나만 알면 되고 값이 어떻게 저장돼 있는지는 몰라도 된다. GoF(Gamma·Helm·Johnson·Vlissides)가 쓴 『Design Patterns』는 이 패턴을 23개 패턴 중 행위(behavioral, 객체 사이의 책임 분배를 다루는) 패턴으로 분류하고, 그 의도를 '집합 객체의 내부 표현을 드러내지 않고 원소에 순차적으로 접근하는 길을 제공한다'로 정의한다.
자바의 for-each, 파이썬의 for, 자바스크립트의 for...of는 전부 이 패턴 위에서 돈다. 이 글은 패턴의 개념과 자바·파이썬·자바스크립트·스위프트가 언어 차원에서 이것을 어떻게 구현했는지를 다룬다. 특정 라이브러리나 리액티브 스트림 같은 확장은 범위 밖이다.
이터레이터 패턴이 푸는 문제는 무엇인가
순회하는 코드를 컬렉션이 데이터를 담아 둔 방식에서 떼어내는 문제를 푼다. 배열은 인덱스로 주소를 계산해 i번째 원소에 곧장 접근한다. 반면 연결 리스트는 노드의 포인터를 타고 다음 노드로 넘어간다. 저장 방식이 이렇게 다르면, 이터레이터가 없을 때는 순회 코드도 자료구조마다 새로 짜야 한다. 배열이면 for 인덱스 루프, 연결 리스트면 while 포인터 루프, 트리면 재귀. 클라이언트가 컬렉션의 내부에 그대로 묶이는 셈이다.
이터레이터는 그 차이를 한 겹 감춘다. 클라이언트는 '다음이 있나'와 '다음을 달라' 두 가지만 물어보고, 그 뒤에서 인덱스를 올리든 포인터를 따라가든 신경 쓰지 않는다. 덕분에 컬렉션 구현을 배열에서 트리로 바꿔도 순회 코드는 손대지 않아도 된다. 한 가지 더 중요한 이득은 순회 상태의 분리다. 지금 몇 번째를 가리키는지를 컬렉션이 아니라 이터레이터가 들고 있어서, 같은 컬렉션을 두 반복문이 동시에 순회해도 커서가 서로 엉키지 않는다.
예를 들어 은행 거래 내역을 화면에 뿌리는 코드를 생각해 보자. 내역이 메모리 안 리스트로 오든, 데이터베이스 커서로 한 줄씩 오든, 순회 코드가 이터레이터만 바라보면 데이터 출처가 바뀌어도 화면 코드는 그대로다. 순회라는 관심사와 저장이라는 관심사가 분리됐기 때문이다.
패턴을 이루는 네 가지 역할
GoF가 정의한 이터레이터 패턴은 네 역할로 나뉜다. 자바 컬렉션이 이 구조를 거의 그대로 따르기 때문에, 개념과 실물을 나란히 놓고 보면 이해가 빠르다.
| 역할 | 책임 | 자바의 예 |
|---|---|---|
| Iterator | 순회 인터페이스 정의 — 다음 요소와 종료 판단 | java.util.Iterator |
| ConcreteIterator | 실제 순회 상태(현재 위치) 관리 | ArrayList 내부 Itr 클래스 |
| Aggregate | 이터레이터를 만들어 주는 인터페이스 | java.util.Iterable |
| ConcreteAggregate | 실제 컬렉션, 자기 이터레이터 반환 | ArrayList |
핵심은 ConcreteAggregate가 자신에게 맞는 ConcreteIterator를 만들어 돌려준다는 점이다. ArrayList는 인덱스로 훑는 이터레이터를, LinkedList는 노드를 타고 가는 이터레이터를 내주지만 둘 다 같은 Iterator 인터페이스를 구현한다. 그래서 받는 쪽 코드는 어느 쪽인지 구분할 필요가 없다. 순회 상태가 컬렉션이 아니라 별도의 이터레이터 객체에 들어가는 것이 이 분리의 뼈대다.
언어마다 이터레이터는 어떻게 생겼나
겉모습은 언어마다 다르지만 계약은 같다. 다음 요소를 내주고, 더 없으면 끝났다고 알린다. 다만 '끝'을 알리는 방식이 두 갈래로 갈린다.
| 언어 | 이터레이터 계약 | 핵심 메서드 | 종료 신호 |
|---|---|---|---|
| Java | Iterator / Iterable | hasNext(), next() | hasNext()가 false |
| Python | __iter__ / __next__ | __next__() | StopIteration 예외 |
| JavaScript | Symbol.iterator | next() | done: true |
| Swift | IteratorProtocol / Sequence | next() | nil 반환 |
| C# | IEnumerator / IEnumerable | MoveNext(), Current | MoveNext()가 false |
자바와 C#은 '다음 있나'를 먼저 묻고 없으면 멈추는 두 단계 방식이다. 파이썬·자바스크립트·스위프트는 next() 하나가 값과 종료를 함께 알린다. 파이썬은 더 줄 게 없으면 StopIteration 예외를 던지고, 자바는 hasNext()가 false를 돌려주는 것으로 갈음한다. MDN의 이터레이션 프로토콜 문서에 따르면 자바스크립트의 next()는 value와 done을 담은 객체를 돌려주고, done이 true가 되면 순회가 끝난다. 스위프트의 next()는 옵셔널을 돌려주다가 nil이 나오면 끝이다. 표현은 달라도 '순차 접근에 종료 신호를 더한다'는 뼈대는 동일하다.
이터러블과 이터레이터는 다르다
둘을 섞어 쓰기 쉽지만 역할이 갈린다. 이터러블(iterable)은 '순회될 수 있는 것' — 컬렉션 자체다. 이터레이터(iterator)는 '지금 어디까지 봤는지를 기억하는 커서'다. 자바에서 List는 Iterable이고, list.iterator()가 돌려주는 물건이 Iterator다. 파이썬에서 리스트는 이터러블이고, iter(리스트)가 돌려주는 것이 이터레이터다.
이 구분이 실무에서 중요한 이유는 수명이 다르기 때문이다. 이터러블은 부를 때마다 새 이터레이터를 만들어 여러 번 순회할 수 있지만, 이터레이터는 대개 한 번 쓰면 소진된다. for 루프를 두 번 돌 때 리스트는 매번 새 커서를 뽑아 두 번 다 정상으로 돈다. 그런데 이미 만들어 둔 이터레이터를 두 for 문에 넣으면 두 번째 루프는 빈손으로 끝난다.
자바와 파이썬으로 직접 구현하기
0부터 지정한 수 직전까지 세는 Range를 자바로 만들면 이렇다. Iterable을 구현해 iterator()에서 상태를 가진 이터레이터를 돌려주면, 그 객체를 곧바로 for-each에 넣을 수 있다.
class Range implements Iterable<Integer> {
 private final int start, end;
 Range(int start, int end) { this.start = start; this.end = end; }

 public Iterator<Integer> iterator() {
  return new Iterator<>() {
   private int cur = start;
   public boolean hasNext() { return cur < end; }
   public Integer next() { return cur++; }
  };
 }
}

// 0, 1, 2 를 출력
for (int n : new Range(0, 3)) System.out.print(n);
파이썬은 같은 일을 두 방식으로 쓸 수 있다. 클래스로 __iter__와 __next__를 직접 구현하는 정석 방식과, 제너레이터로 반복 골격을 걷어내는 방식이다. yield가 붙은 함수는 파이썬이 __next__를 알아서 만들어 주고, 함수가 멈췄던 자리부터 다시 이어서 실행한다.
# 클래스로 직접 구현: __iter__ + __next__
class Countdown:
 def __init__(self, n):
  self.n = n
 def __iter__(self):
  return self
 def __next__(self):
  if self.n <= 0:
   raise StopIteration
  self.n -= 1
  return self.n + 1

# 제너레이터로 같은 일을 (골격 없이)
def countdown(n):
 while n > 0:
  yield n
  n -= 1

print(list(countdown(3))) # [3, 2, 1]
두 코드가 하는 일은 같지만 제너레이터 쪽이 훨씬 짧다. 현업에서 커스텀 순회가 필요할 때 파이썬·자바스크립트라면 대개 제너레이터로 해결하고, 자바라면 위처럼 익명 클래스나 Iterable 구현으로 푼다. 파이썬 공식 문서의 이터레이터 타입 설명도 이 두 축, 곧 프로토콜과 제너레이터를 이터레이터의 표준 표현으로 다룬다.
외부 이터레이터와 내부 이터레이터
순회의 제어권을 누가 쥐느냐에 따라 두 종류로 갈린다. GoF는 이를 외부(external) 이터레이터와 내부(internal) 이터레이터로 구분한다.
외부 이터레이터는 클라이언트가 직접 next()를 호출하며 한 걸음씩 나아간다. for 루프에서 hasNext와 next를 부르는 자바 코드가 전형이다. 중간에 멈추거나, 조건에 맞을 때만 골라내거나, 두 컬렉션을 나란히 훑는 세밀한 제어가 쉽다. 내부 이터레이터는 반대로 컬렉션이 순회를 직접 돌리고 클라이언트는 '각 요소에 이 일을 하라'는 함수만 넘긴다. 자바의 forEach, 자바스크립트 배열의 forEach와 map, 파이썬의 컴프리헨션이 이쪽이다. 코드는 짧아지지만 순회 도중 빠져나오기 같은 제어에는 제약이 붙는다.
실무 감각으로는 요소마다 같은 변환을 걸 때는 내부 방식이 읽기 좋고, 순회를 조기 종료하거나 여러 컬렉션의 커서를 함께 움직여야 할 때는 외부 방식이 편하다. 둘 중 하나가 늘 옳은 게 아니라 제어의 세밀함과 코드의 간결함을 맞바꾸는 선택이다.
실무에서 걸리는 함정
가장 자주 데는 곳은 순회 중 수정이다. 오라클 자바의 Iterator 문서는 이터레이터로 순회하는 동안 컬렉션이 이터레이터 자신의 remove() 외의 방법으로 바뀌면 동작을 보장하지 않는다고 밝히며, ArrayList 같은 구현은 이때 ConcurrentModificationException을 던진다. 리스트를 돌면서 항목을 지우고 싶으면 컬렉션의 remove가 아니라 이터레이터의 remove()를 써야 한다. 파이썬도 마찬가지여서, 파이썬 공식 문서는 딕셔너리를 순회하는 동안 크기를 바꾸면 RuntimeError가 날 수 있다고 안내한다. 순회 중 삭제가 필요하면 복사본을 돌거나 살릴 항목만 새 리스트로 모으는 편이 안전하다.
두 번째는 일회용 이터레이터다. 파이썬 제너레이터와 자바스크립트 이터레이터는 한 번 끝까지 소비하면 재사용되지 않는다. 같은 데이터를 두 번 순회하려면 이터러블에서 새 이터레이터를 다시 얻어야 한다. 리스트처럼 매번 다시 돌 수 있는 컬렉션과 헷갈리면, 두 번째 루프가 조용히 아무것도 돌지 않는 버그로 이어진다.
세 번째는 함정이라기보다 이점이다. 이터레이터는 요청받을 때 다음 값 하나만 계산하므로, 100만 개를 담은 리스트를 통째로 메모리에 올리지 않고도 값을 하나씩 흘려보낼 수 있다. 이 지연 평가 덕분에 거대한 파일을 한 줄씩 읽거나, 페이지 단위로 끊어 오는 원격 API 결과를 이어 붙이는 일이 가벼워진다. 순회 상태를 이터레이터가 밖에서 들고 있기에, 전체를 미리 만들지 않고 필요한 만큼만 당겨 쓸 수 있는 것이다.
직접 구현이 필요한 순간
대부분의 상황에서는 언어가 제공하는 컬렉션의 이터레이터를 그냥 쓰면 된다. 직접 구현할 값어치가 생기는 건 표준 컬렉션이 아닌 나만의 자료구조, 곧 트리나 그래프, 페이지네이션이 걸린 원격 리소스를 남들이 표준 순회 문법으로 훑게 열어 줄 때다. 이때 Iterable(또는 스위프트의 Sequence, 자바스크립트의 Symbol.iterator)을 구현해 두면, 그 구조를 쓰는 사람은 내부가 트리인지 원격 호출인지 몰라도 for 한 줄로 순회한다. 순회의 편의를 열어 주면서 내부 표현은 감추는 것, 그게 이 패턴이 30년 넘게 살아남은 이유다.